Microsoft 365 : un correctif Windows défectueux à l’origine de la panne mondiale
Plus de 80 % des serveurs qui reçoivent les connexions à Microsoft 365 ne répondaient plus au pire moment de la panne. Microsoft a publié un premier rapport à propos de la panne mondiale des 12 et 13 novembre 2026, et l'explication diffère de celle avancée à chaud. Voici ce que l'on sait.
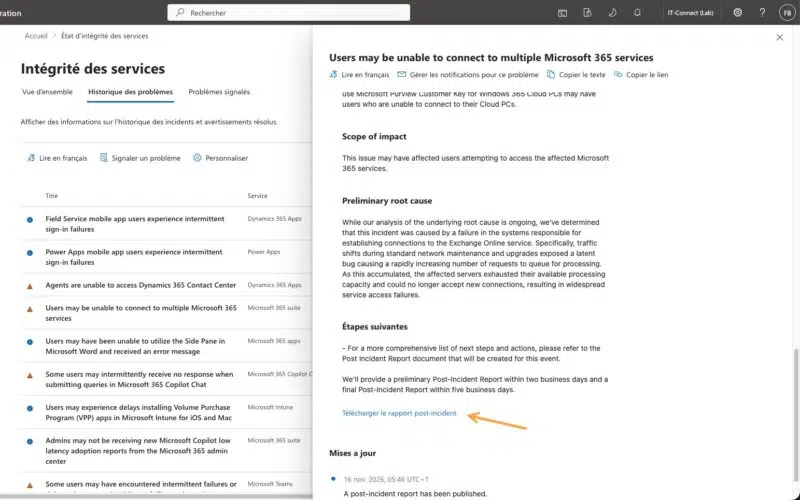
Jeudi 12 novembre et vendredi 13 novembre 2026 ont été deux journées compliquées pour les utilisateurs de Microsoft, et ce, à l'échelle mondiale. Lors de cette panne, Exchange Online a été le service le plus touché : la plupart des utilisateurs ne pouvaient plus ouvrir leur boîte aux lettres, et les e-mails arrivaient en retard. Ce week-end, Microsoft a publié un premier rapport, qualifié de rapport préliminaire, à propos de cette panne. Il a été diffusé via le centre d'administration Microsoft 365, et il prend la forme d'un document Word que j'ai pris le temps de lire pour vous ! Dans le même temps, Charles Lamanna, vice-président exécutif de Microsoft, en a aussi publié une version abrégée sur X, accompagnée d'excuses.
Première information importante : Microsoft indique que la période d'impact de cet incident s'étend du jeudi 12 novembre à 17 h 20 au vendredi 13 novembre à 17 h 10 (heure française), soit près de 24 heures. Dans un premier temps, Microsoft évoquait un problème lié au réseau, mais ce rapport désigne un défaut dans un processus interne de Windows.
Un bug dormant depuis juillet, réveillé par une panne excessive
Lors de cet incident, tout s'est joué au niveau de la passerelle réseau de Microsoft, c'est-à-dire au niveau des serveurs frontaux qui reçoivent les connexions des utilisateurs avant de les transmettre à des services comme Exchange Online. Ces serveurs tournent sous Windows, avec un correctif que Microsoft avait préparé spécialement pour eux. C'est ce correctif qui contenait le défaut. "Ni le défaut sous-jacent ni le correctif ne s'appliquent aux autres déploiements de Windows", précise Microsoft. Ce bug est donc propre à l'infrastructure de Microsoft 365.
Pour qu'il se déclenche, trois conditions devaient être réunies, et c'est malheureusement ce qui s'est passé :
Un correctif défectueux : sous une forte charge, de nombreuses tâches d'un processus interne de Windows se disputent l'accès aux mêmes ressources. Le processeur et la mémoire saturent, et le serveur cesse de répondre. Déployé depuis juillet, le correctif a pourtant tourné plus de trois mois sans incident. Les tests de charge, menés surtout sur des machines moins puissantes, ne l'ont pas repéré, alors que le problème s'aggrave sur du matériel récent doté de nombreux cœurs.
Plus de trafic : Microsoft 365 dispose de deux passerelles indépendantes. Jeudi à 2 h 07, le trafic de Teams a été basculé automatiquement sur la passerelle principale, celle qui sert aussi Exchange Online. Une opération de routine, mais la charge de cette passerelle a ensuite grimpé tout au long de la journée.
Moins de serveurs : près de 14 % de sa capacité était déjà hors service, à cause d'un problème sans rapport survenu la veille.
Pris isolément, aucun de ces éléments ne posait problème. Ensemble, ils ont fait franchir aux serveurs le seuil de charge où le défaut se manifeste, jeudi en fin d'après-midi (heure française), en plein pic de trafic aux États-Unis. L'effet domino s'est alors enclenché :
Des serveurs saturent : les requêtes s'accumulent jusqu'à ce que ces serveurs ne répondent plus.
Le trafic est redirigé : comme prévu, les systèmes de gestion du trafic envoient les utilisateurs vers les serveurs encore sains. C'est d'habitude ce qui rend le service résilient.
Les suivants cèdent à leur tour : la même charge se répartit désormais sur moins de serveurs, qui ont tous le même défaut. Ils saturent, et le trafic repart vers les suivants.
La panne devient mondiale : en moins de deux heures, plus de 80 % des serveurs de la passerelle ne répondent plus. Les cloisonnements censés empêcher une panne de passer d'une région à l'autre n'ont pas tenu, à cause d'un autre problème que Microsoft ne détaille pas encore.
Donc ici, la redirection automatique du trafic, conçue pour absorber une panne, a accéléré sa propagation à cause d'un bug commun.
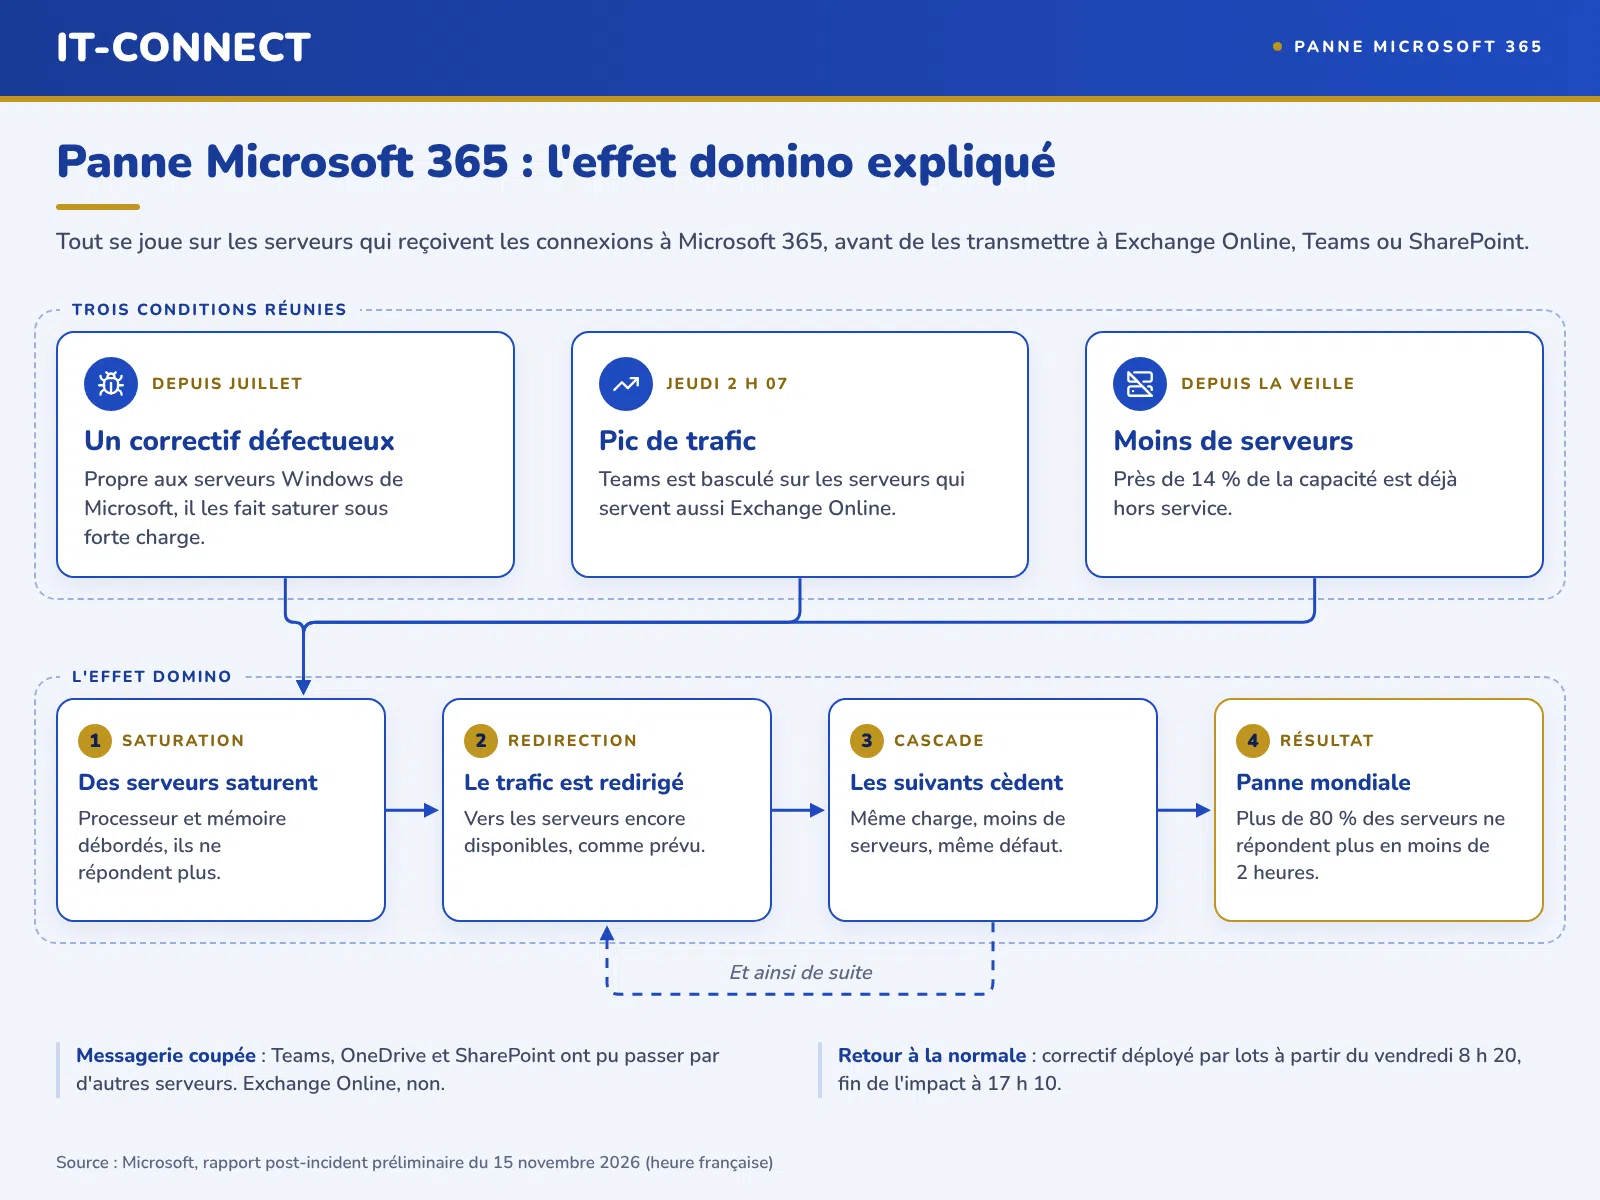
Tous les services n'ont pas été touchés de la même façon. Teams, OneDrive, SharePoint et les applications Office ont pu quitter la passerelle défaillante : les conversations et réunions Teams ont fonctionné normalement pendant la majeure partie de la panne. Exchange Online, lui, ne peut pas changer de passerelle en raison du volume qu'il représente, d'où une messagerie inaccessible pour la plupart des utilisateurs.
Pourquoi le rétablissement a-t-il été si long ?
Remettre le service en route a pris beaucoup plus de temps que d'habitude, pour trois raisons :
Des serveurs aussitôt resaturés : chaque serveur redémarré recevait d'un coup tout le trafic resté en attente, et cessait de répondre presque aussitôt.
Une récupération automatique dépassée : les mécanismes qui relancent habituellement les serveurs défaillants ne sont pas prévus pour un parc presque entièrement à l'arrêt.
Un retour arrière impossible : le défaut datant de plusieurs mois, les outils habituels pour annuler une modification (retour à la version précédente, déploiement progressif, interrupteurs logiciels de type feature flags) ne permettaient pas de le faire rapidement.
Le diagnostic s'est précisé dans la nuit de jeudi à vendredi, et le retour à la normale s'est fait par étapes :
À 1 h 30 : les équipes localisent le problème dans l'établissement des connexions, où des processus concurrents empêchent les serveurs de traiter les demandes.
À 8 h 20 : un premier correctif est appliqué à une partie de l'infrastructure. Il ramène le code Windows fautif à sa dernière version stable.
Dans la matinée : Microsoft étend ce correctif par lots, ce qui implique à chaque fois de sortir un lot du service, de mettre à jour le serveur et de le redémarrer. Ici, Microsoft a commencé par traiter les régions en pleine journée de travail.
À 12 h 35 : l'Europe retrouve une disponibilité normale.
À 17 h 10 : Microsoft estime que les utilisateurs ne sont plus touchés et passe en phase de surveillance, le temps d'écouler les e-mails en attente.
Microsoft indique avoir déjà appliqué plusieurs mesures : de la capacité supplémentaire pour soulager l’infrastructure, une surveillance renforcée des redirections de trafic et de l’état des connexions, ainsi que des garde-fous sur la répartition du trafic pour éviter un nouvel effet domino. Le délai de remise des e-mails a aussi été allongé, pour que les messages retardés ne soient pas renvoyés comme non distribuables.
Microsoft publiera un rapport final le 20 novembre 2026 à propos de cet incident. Affaire à suivre.
Ajouter IT-Connect à mes
sources préférées
Cofondateur d'IT-Connect et Microsoft MVP "Cloud and Datacenter Management". Mon obsession depuis près de 15 ans ? Rendre l'administration système et la cybersécurité accessibles, que vous soyez junior ou confirmé. Plus qu'un métier, l'IT est pour moi une véritable passion. J’accompagne au quotidien les sysadmins et les professionnels de l’IT dans leur montée en compétences et leur veille technique.